Créer des images avec l'IA
Décrire une image en quelques phrases et la voir apparaître en moins d'une minute : en quelques années, la création d'images par intelligence artificielle est passée des laboratoires de recherche aux assistants du quotidien. Cette page explique quel outil choisir en 2026, comment formuler votre demande et ce que vous avez le droit de faire des images obtenues. Elle retrace aussi, images à l'appui, l'histoire de ces générateurs.
Quel outil choisir en 2026 ?
Les assistants conversationnels créent maintenant des images directement dans la conversation, et les générateurs spécialisés restent utiles pour des besoins précis :
ChatGPT : la création d'images est incluse dans toutes les offres, y compris la version gratuite. Depuis ChatGPT Images 2.0 (avril 2026), les offres payantes ajoutent un mode avec réflexion : le modèle analyse la demande plus en profondeur, peut chercher des informations sur le Web et livrer plusieurs variantes cohérentes entre elles. Le texte intégré aux images (affiches, couvertures, schémas annotés) est bien rendu, y compris dans des alphabets non latins.
Gemini : l'assistant de Google crée des images avec ses modèles Nano Banana, conçus aussi pour retoucher des photos existantes.
Copilot : l'assistant de Microsoft utilise depuis mars 2026 son propre modèle d'images, MAI-Image-2.
Midjourney : longtemps la référence pour le rendu artistique. La version 8.1, sortie le 30 avril 2026, produit des images en 2K sans agrandissement (voir notre page Midjourney).
FLUX (Black Forest Labs) : des modèles très réalistes, dont certains peuvent être téléchargés pour tourner sur votre propre machine. FLUX 3, annoncé en juillet 2026, génère aussi des vidéos avec le son.
Ideogram : apprécié pour le texte intégré aux images. Ideogram 4.0 (juin 2026) est le premier modèle de la marque que l'on peut télécharger (licence non commerciale).
Adobe Firefly : disponible sur son site et directement dans Photoshop. Il donne aussi accès à des modèles d'autres éditeurs, comme FLUX.2 ou Nano Banana.
Leonardo AI : nombreux réglages et plusieurs modèles au choix.
Pour un usage courant (illustrer un article, une publication, une présentation), l'assistant que vous utilisez déjà suffit. Les générateurs spécialisés se justifient pour un rendu artistique travaillé, un grand volume d'images ou un usage professionnel. La sélection complète est sur la page IA - Intelligences Artificielles.
Comment demander une image à une IA
Décrivez l'image voulue, en français : le sujet, le cadrage, le style (photo, illustration, aquarelle, icône plate), l'ambiance et les couleurs.
Indiquez le format : carré, paysage pour un en-tête d'article, portrait pour un visuel de réseau social.
Si l'image doit contenir du texte, écrivez-le entre guillemets, exactement comme il doit apparaître.
Corrigez par petites touches : « garde la même scène mais plus lumineuse », « retire la tasse », « passe en noir et blanc ». Les assistants comme ChatGPT et Gemini repartent de l'image précédente.
Pour ne modifier qu'une partie de l'image, utilisez l'outil de sélection quand il existe (ChatGPT, Firefly, Midjourney) : entourez la zone, puis décrivez le changement. La retouche peut déborder un peu de la zone choisie.
Exemple de demande : « Crée une image au format paysage pour l'en-tête d'un article de blog sur le télétravail : un bureau en bois près d'une fenêtre, lumière du matin, ordinateur portable ouvert, une plante verte, style photo naturelle, sans texte. »
Vous pouvez aussi partir de votre propre image (photo, croquis, capture d'écran) et demander de la transformer : changer le fond, l'éclairage ou le style, ou vous en servir comme modèle. Pour d'autres techniques de demande, voir Mieux utiliser ChatGPT.
Photos réalistes et personnes réelles
Les générateurs actuels produisent sans difficulté des images d'aspect photographique. Les limites portent surtout sur le contenu : les éditeurs restreignent les images de personnes réelles et bloquent notamment les deepfakes à caractère sexuel. Si une demande est refusée, reformulez-la sans viser une personne réelle identifiable.
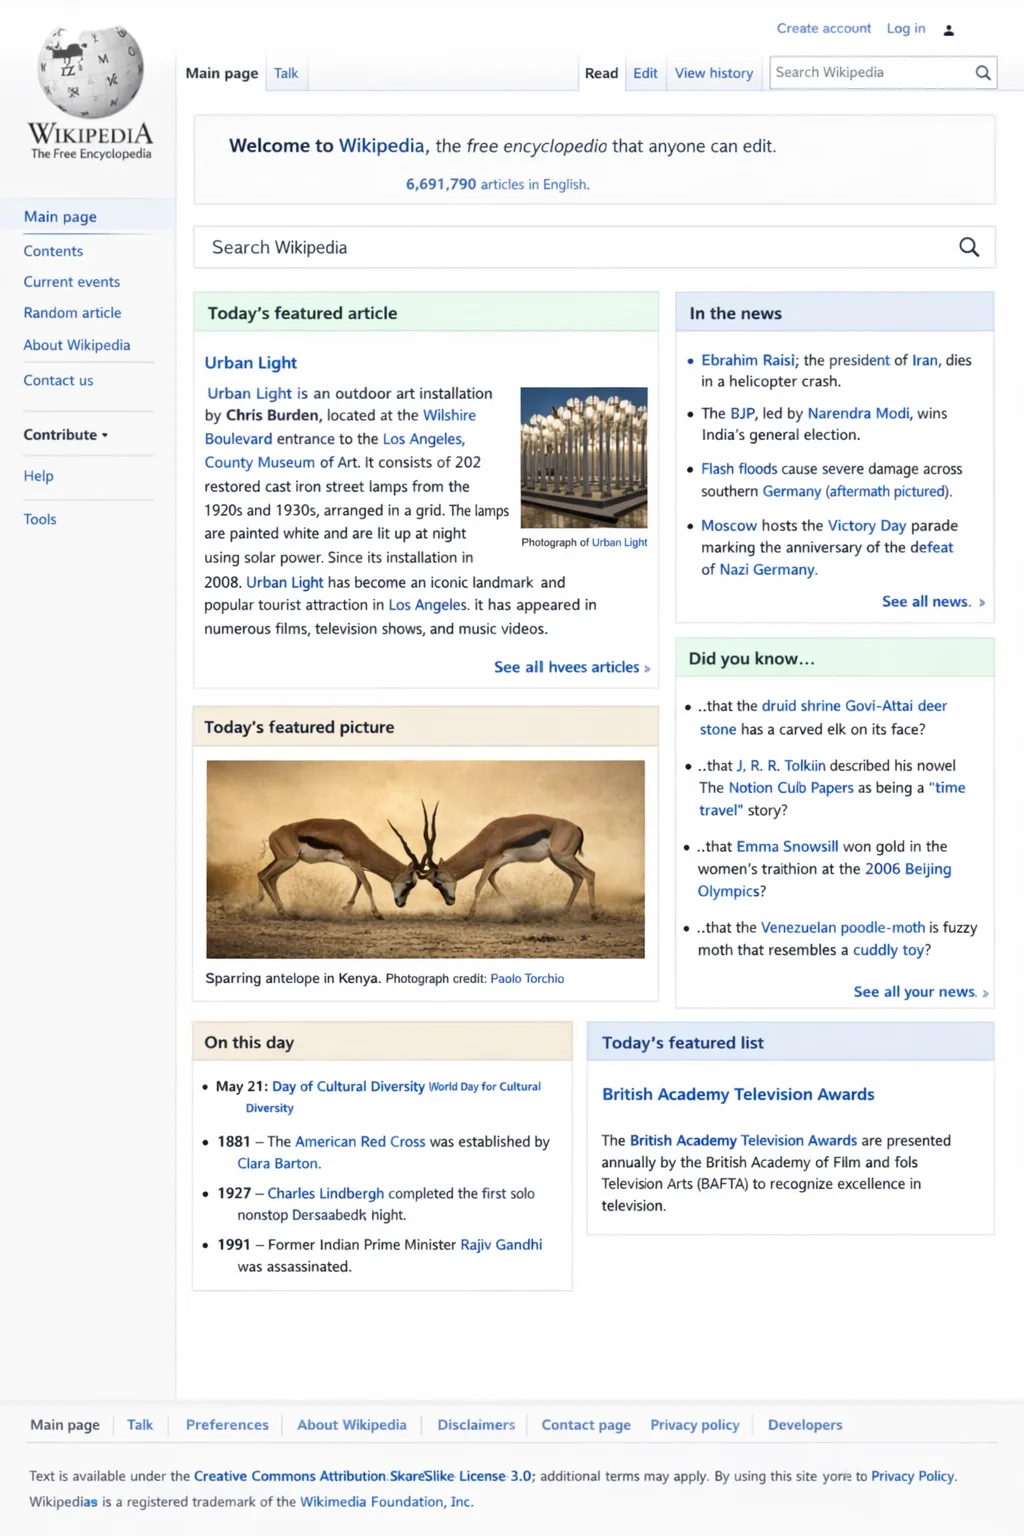
Relisez toujours le texte et les détails (mains, logos, chiffres) avant de publier une image : les schémas très détaillés et les textures denses restent des points faibles.
Plusieurs éditeurs, dont OpenAI, ajoutent aux images des métadonnées C2PA, un standard qui signale qu'une image a été créée par une IA. Et depuis le 2 août 2026, l'AI Act européen impose de signaler les hypertrucages (deepfakes).
Pouvez-vous utiliser ces images sur votre site ?
Chez la plupart des éditeurs, les conditions d'utilisation vous laissent la propriété des images générées. Par exemple, les conditions d'utilisation d'OpenAI (version européenne mise à jour en janvier 2026) indiquent que vous êtes propriétaire des contenus générés, dans la mesure permise par la loi applicable. Elles précisent aussi que ces contenus ne sont pas forcément uniques : un autre utilisateur peut obtenir une image très proche. Lisez les conditions de l'outil choisi, car les droits peuvent dépendre de l'offre souscrite.
Deux conséquences pratiques :
pour illustrer un article ou une page, une image générée par IA convient ;
pour un logo ou un élément d'identité de marque, faites retravailler l'image par un graphiste : la protection par le droit d'auteur d'une image produite telle quelle par une IA reste incertaine, alors qu'un vrai travail humain sur l'image renforce vos droits.
Avant de publier, pensez au poids de l'image : convertissez-la en WebP et redimensionnez-la à la taille d'affichage (voir les formats d'images sous WordPress). Si vous avez besoin d'une version plus grande, un outil d'upscale l'agrandit sans la rendre floue.
Historique de la création d'images par IA
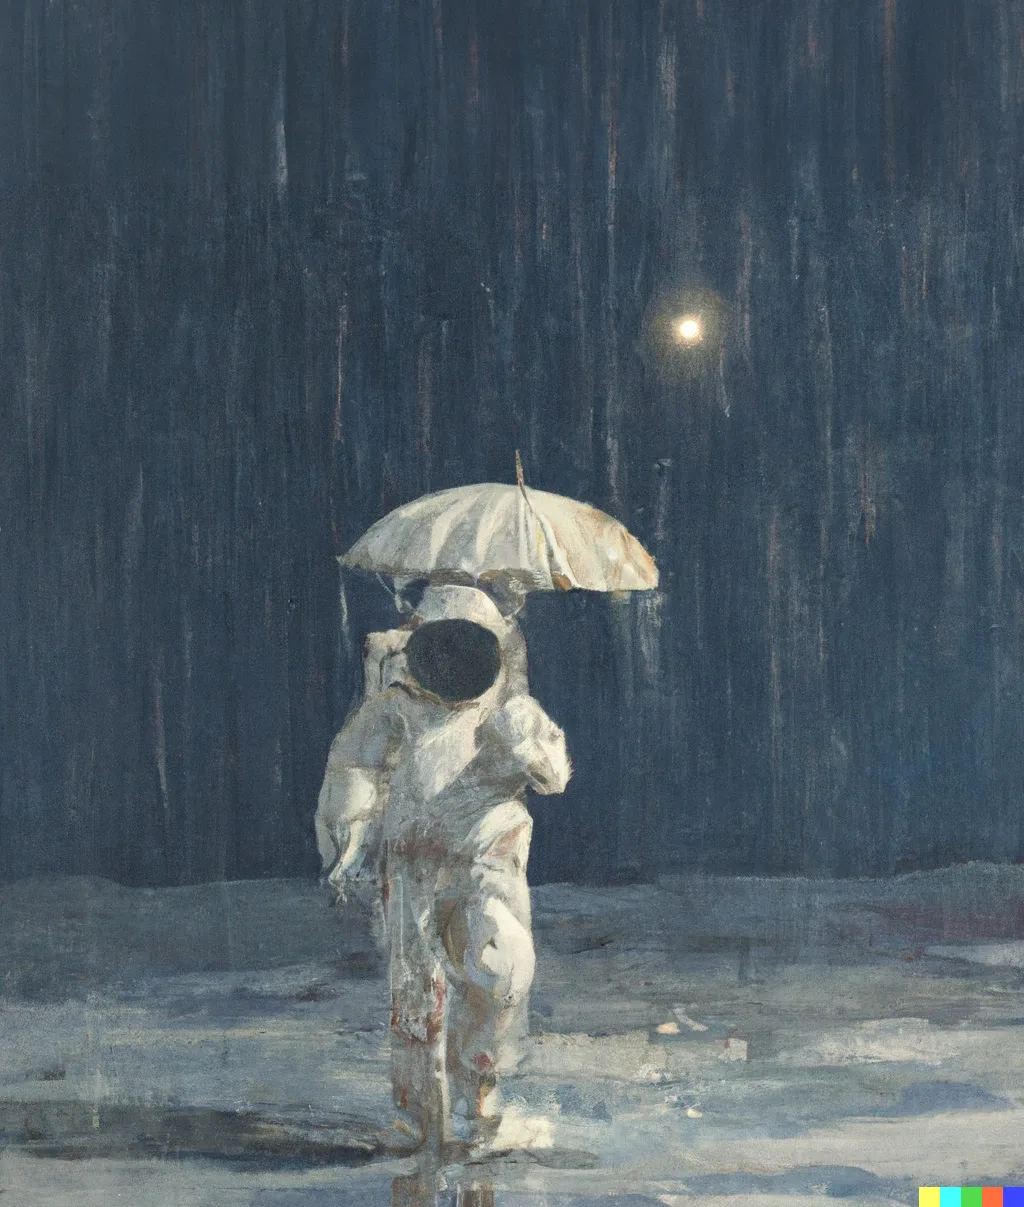
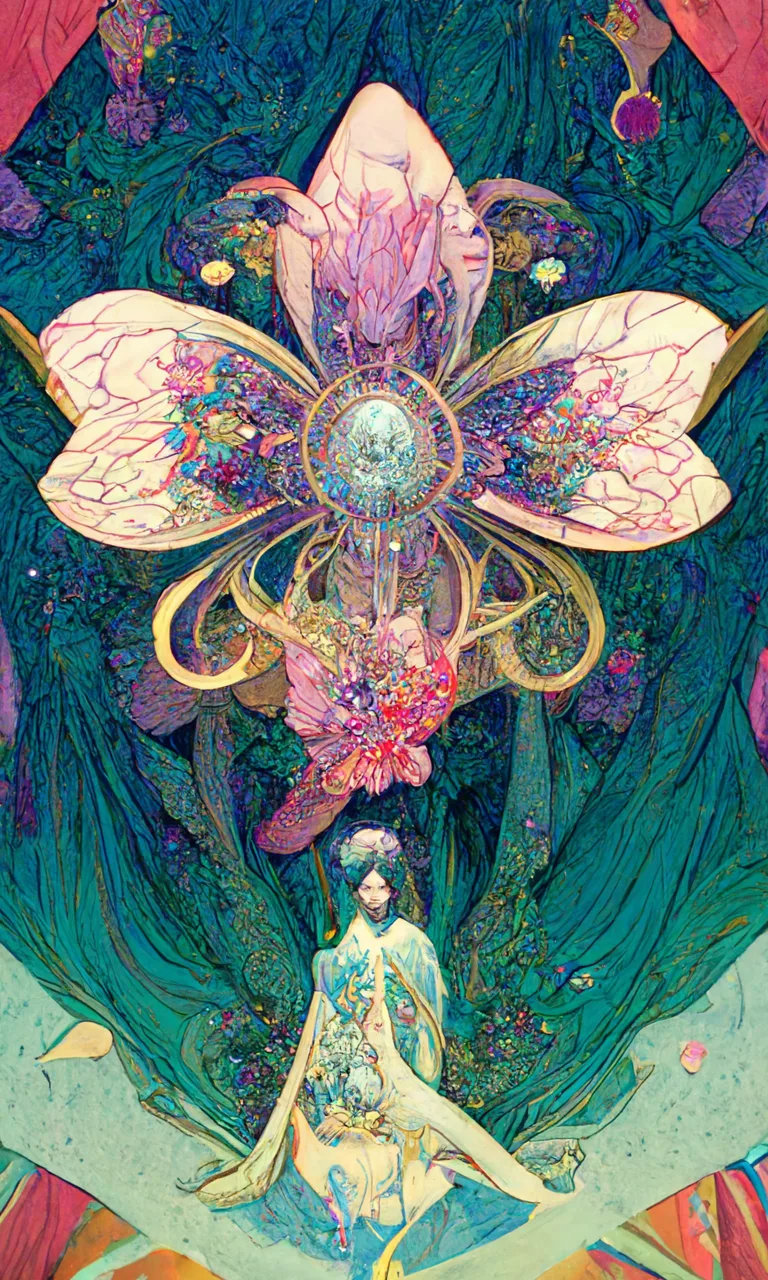
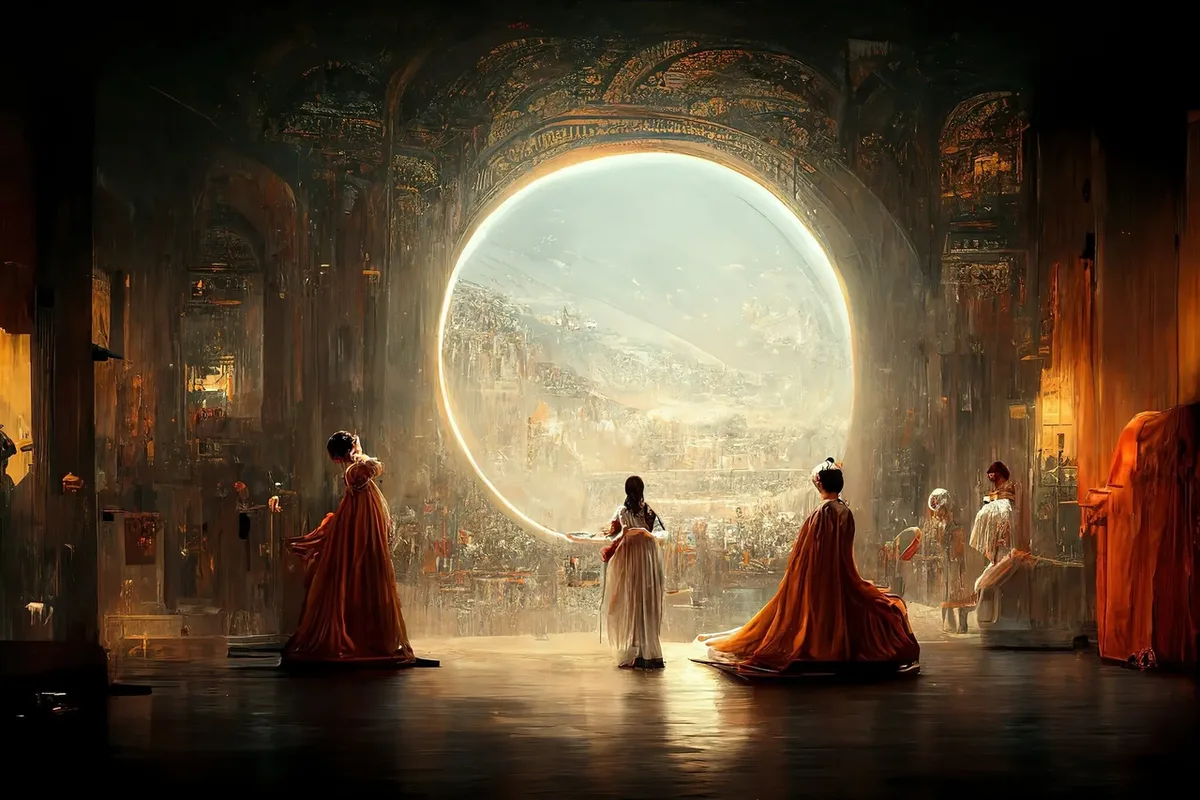
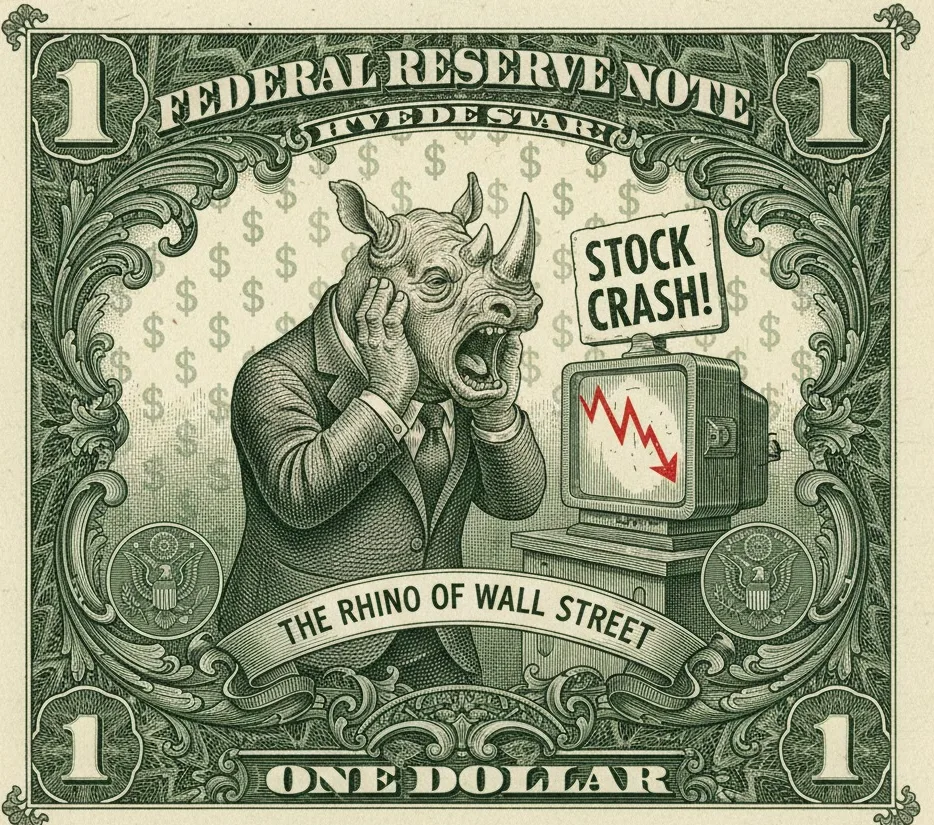
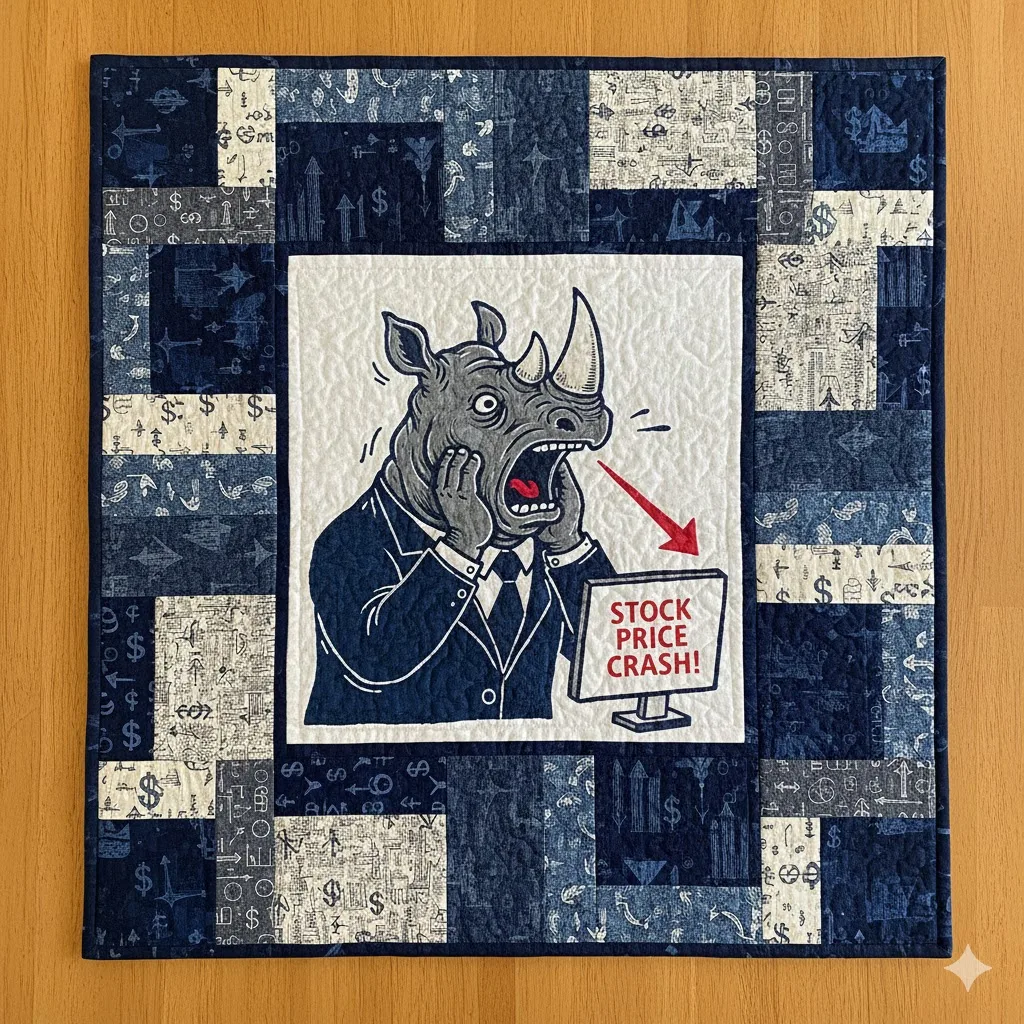
En une douzaine d'années, la génération d'images est passée de petites taches floues à des images photoréalistes produites en quelques secondes. Les images de cette section viennent de Wikimedia Commons (crédits en fin de page).
La même demande, de 2015 à 2025
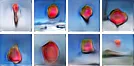
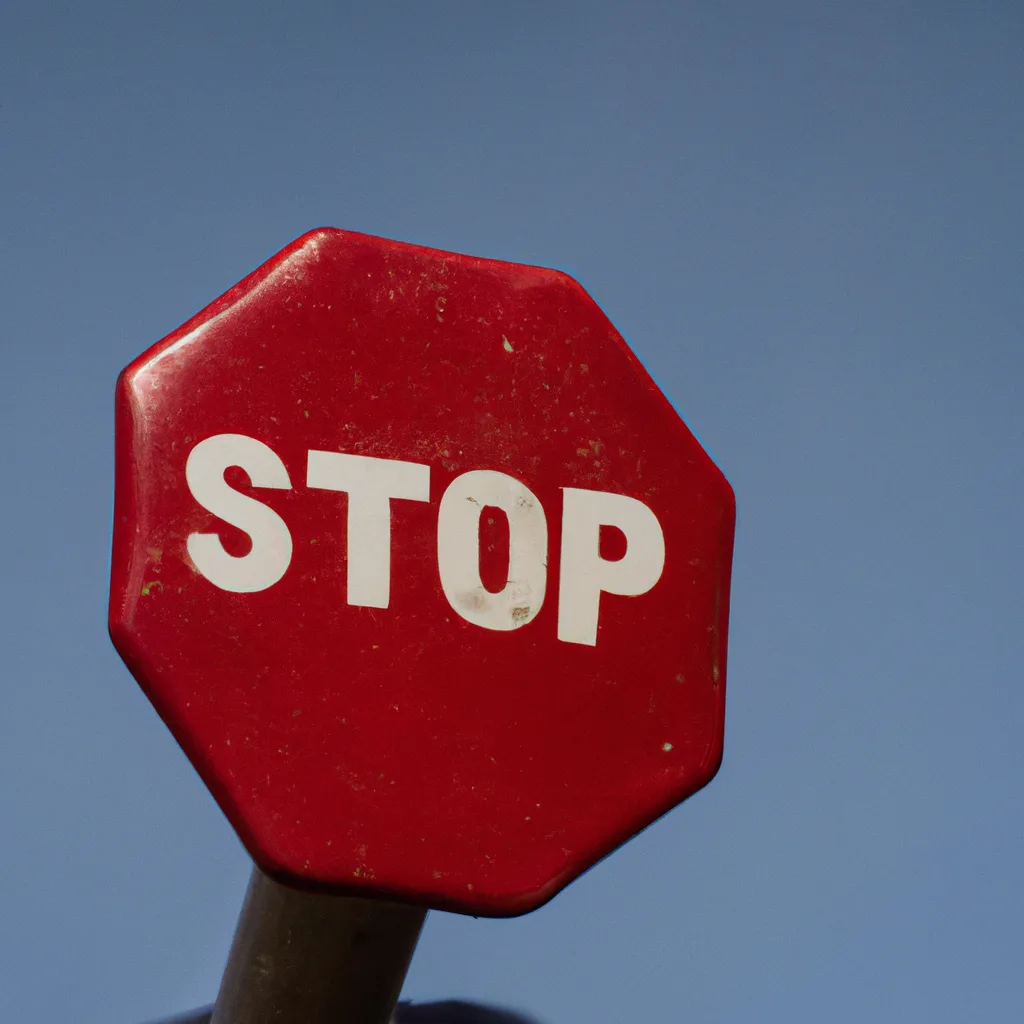
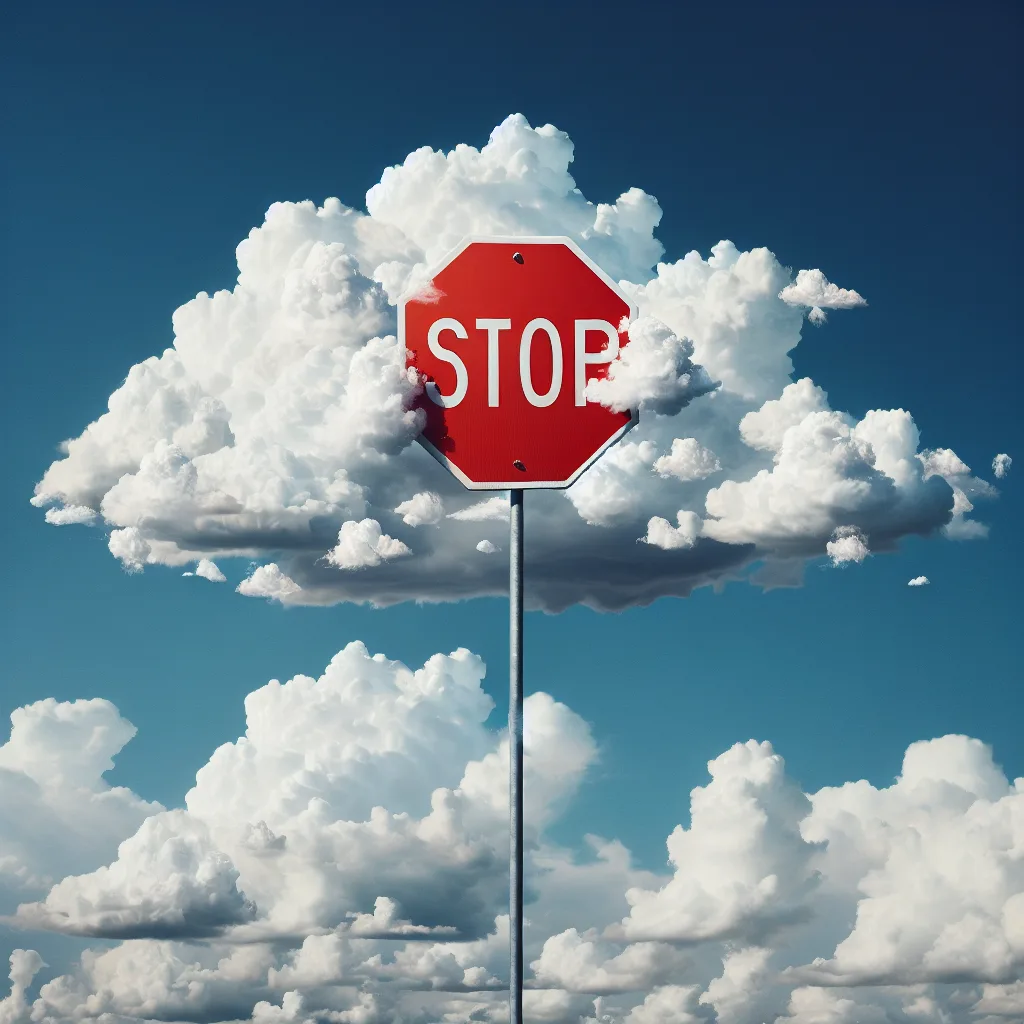
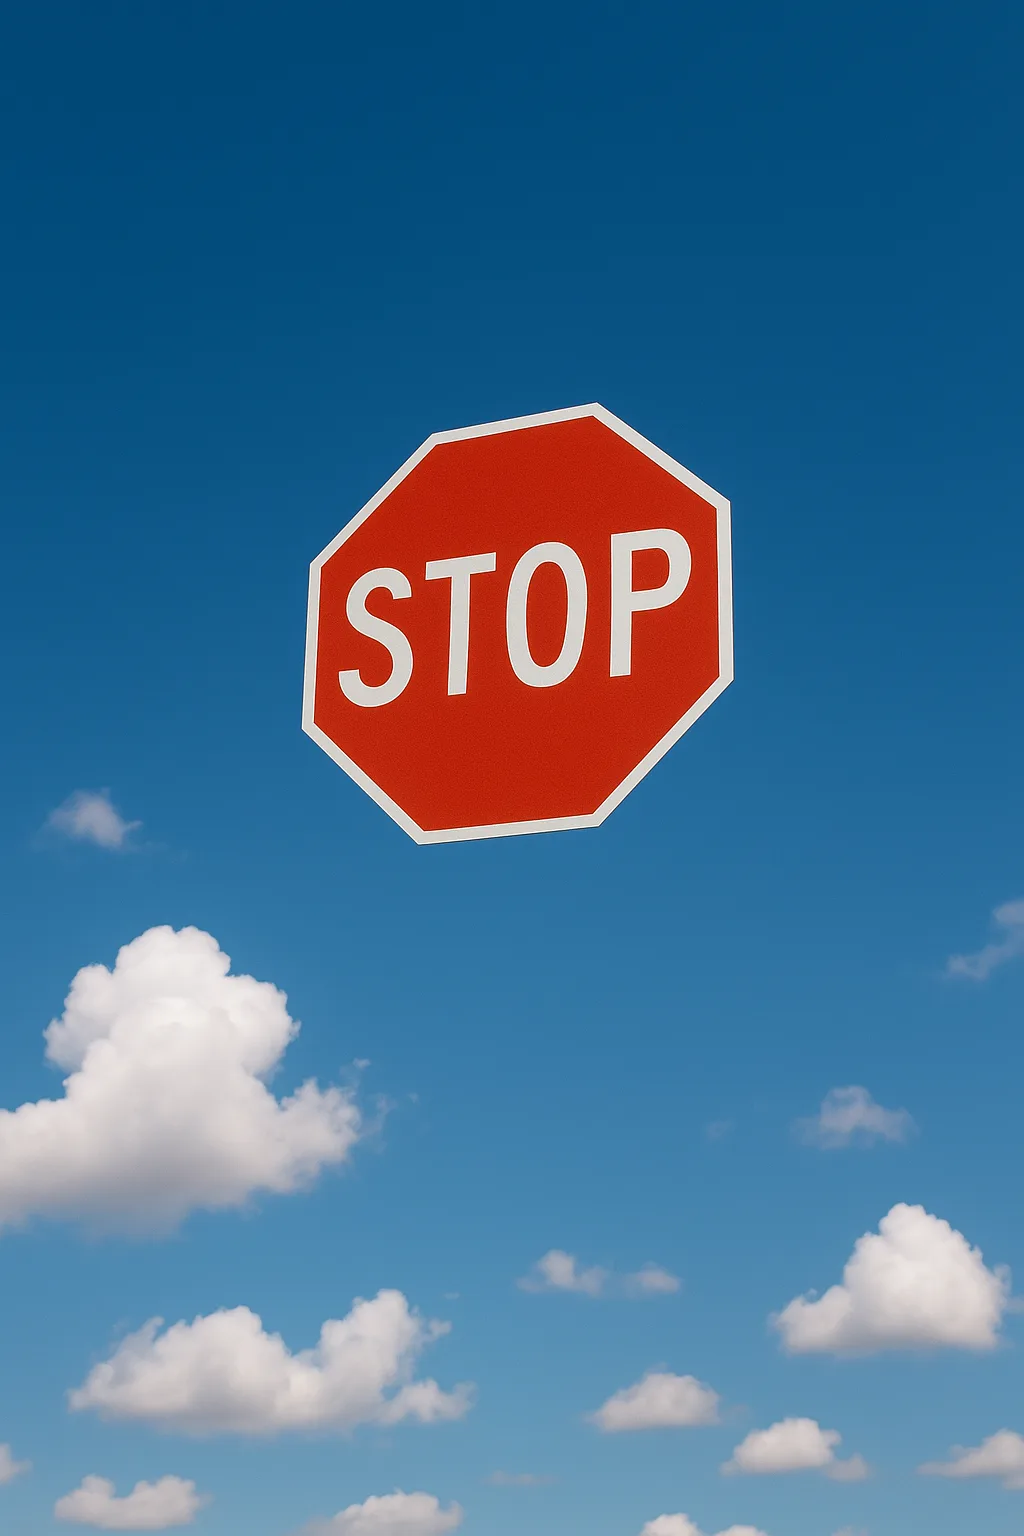
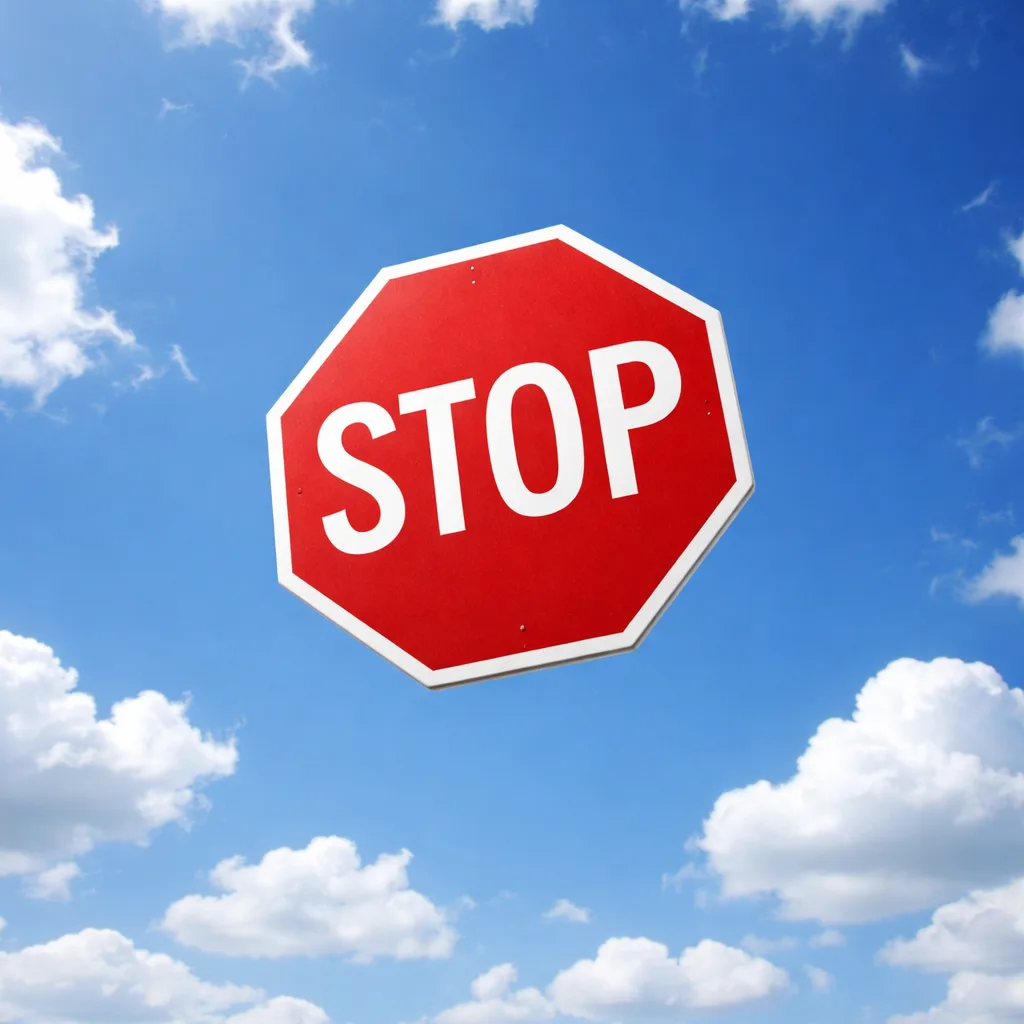
Des contributeurs de Wikimedia Commons ont soumis la même phrase, « A stop sign is flying in blue skies » (un panneau stop vole dans un ciel bleu), à plusieurs générations de modèles. En 2015, alignDRAW ne produisait que de toutes petites images floues, où l'on devine à peine un panneau rouge.
2014-2019 : les débuts avec les GAN
Juin 2014 : Ian Goodfellow et ses coauteurs publient les réseaux antagonistes génératifs (GAN). Deux réseaux de neurones s'affrontent : l'un crée des images, l'autre tente de les distinguer de vraies photos.
Novembre 2015 : des chercheurs de l'université de Toronto présentent alignDRAW, le premier modèle qui génère une image à partir d'une phrase.
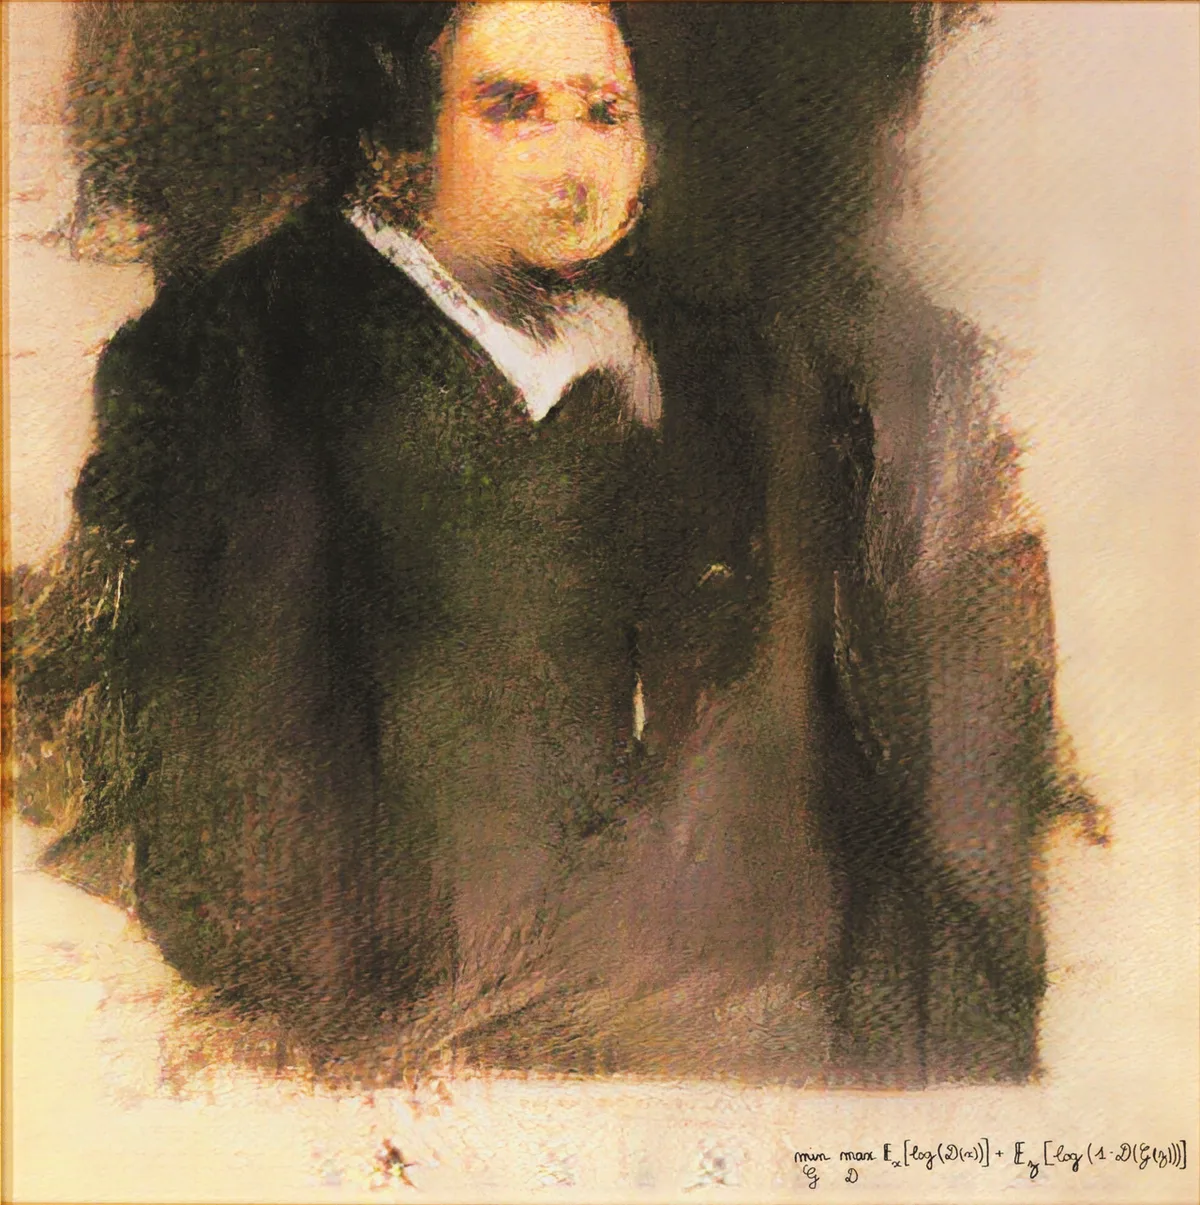
Octobre 2018 : le Portrait d'Edmond de Belamy, créé par le collectif français Obvious avec un GAN, est vendu 432 500 $ chez Christie's, plus de 40 fois son estimation.
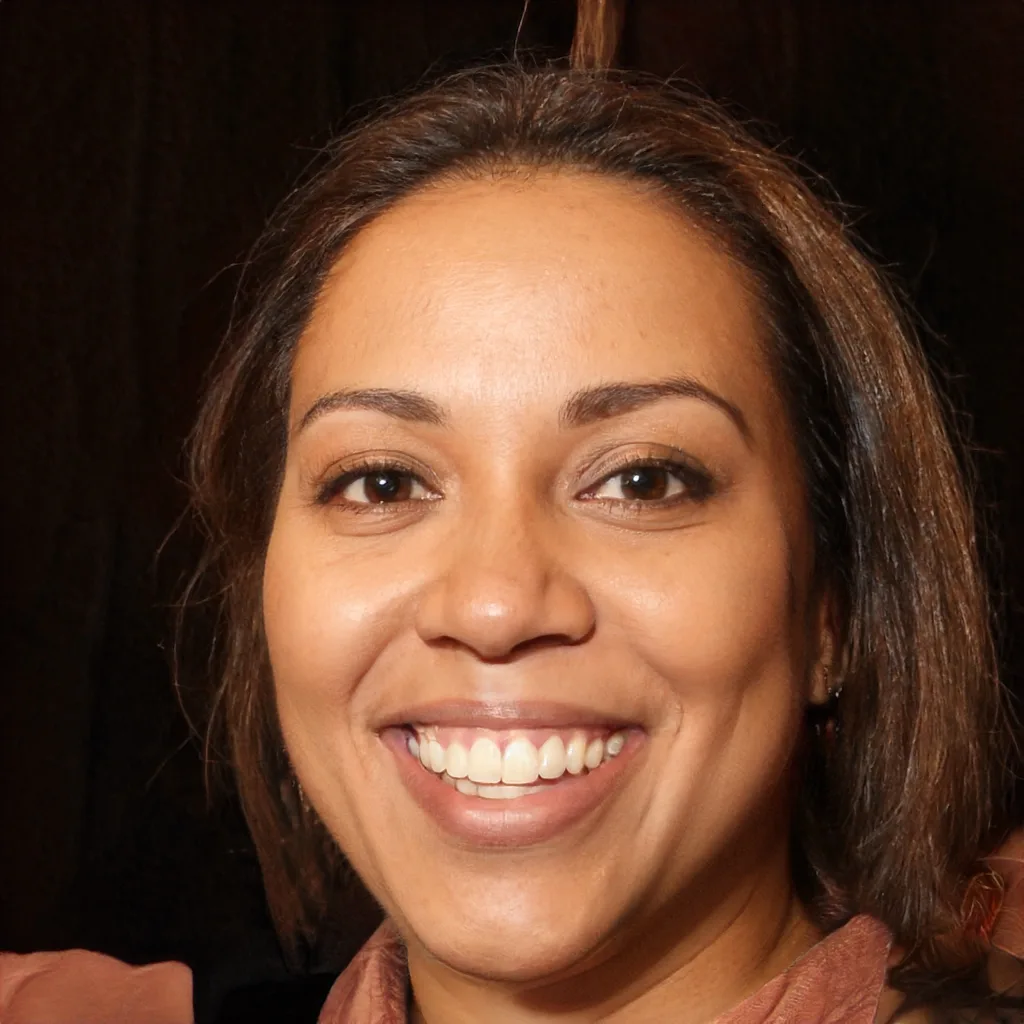
2019 : les modèles StyleGAN de Nvidia créent des visages photoréalistes de personnes qui n'existent pas.
2021-2022 : une phrase suffit
5 janvier 2021 : OpenAI présente DALL·E, qui crée des images à partir d'une phrase, et CLIP, un modèle qui relie les images et les textes.
6 avril 2022 : DALL·E 2 crée des images réalistes à partir d'une description en langage courant.
12 juillet 2022 : Midjourney ouvre sa bêta au public, sur Discord.
22 août 2022 : Stability AI publie Stable Diffusion, un générateur d'images ouvert que chacun peut installer sur son ordinateur.
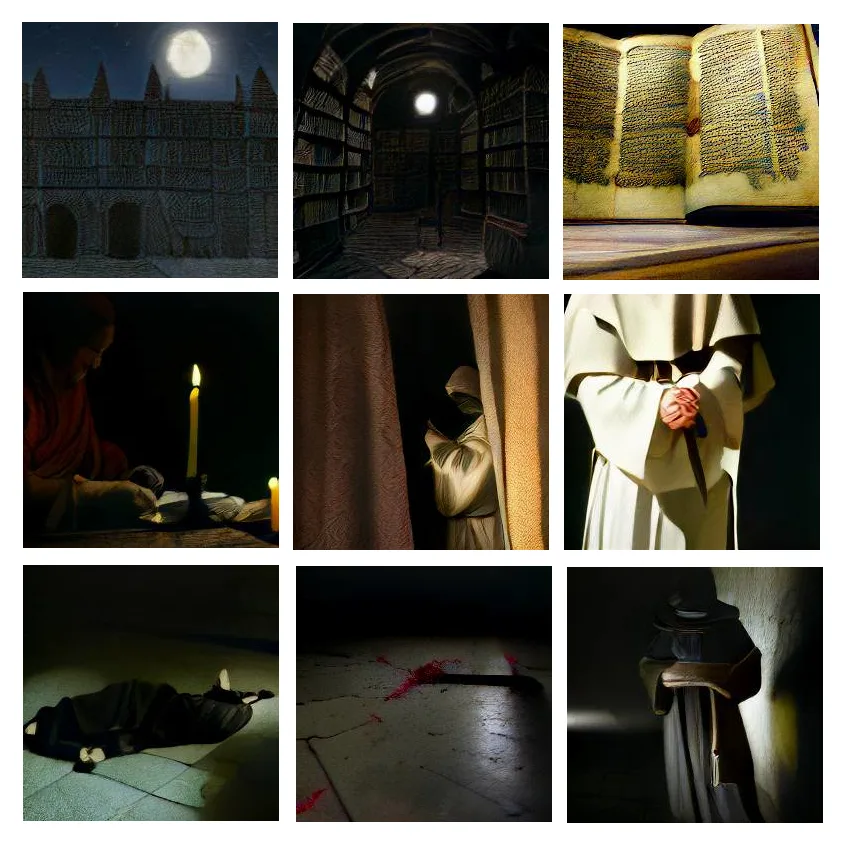
Août 2022 : Théâtre D'opéra Spatial, créé avec Midjourney par Jason M. Allen, remporte le concours d'art numérique de la foire d'État du Colorado et lance le débat sur le statut artistique de ces images.
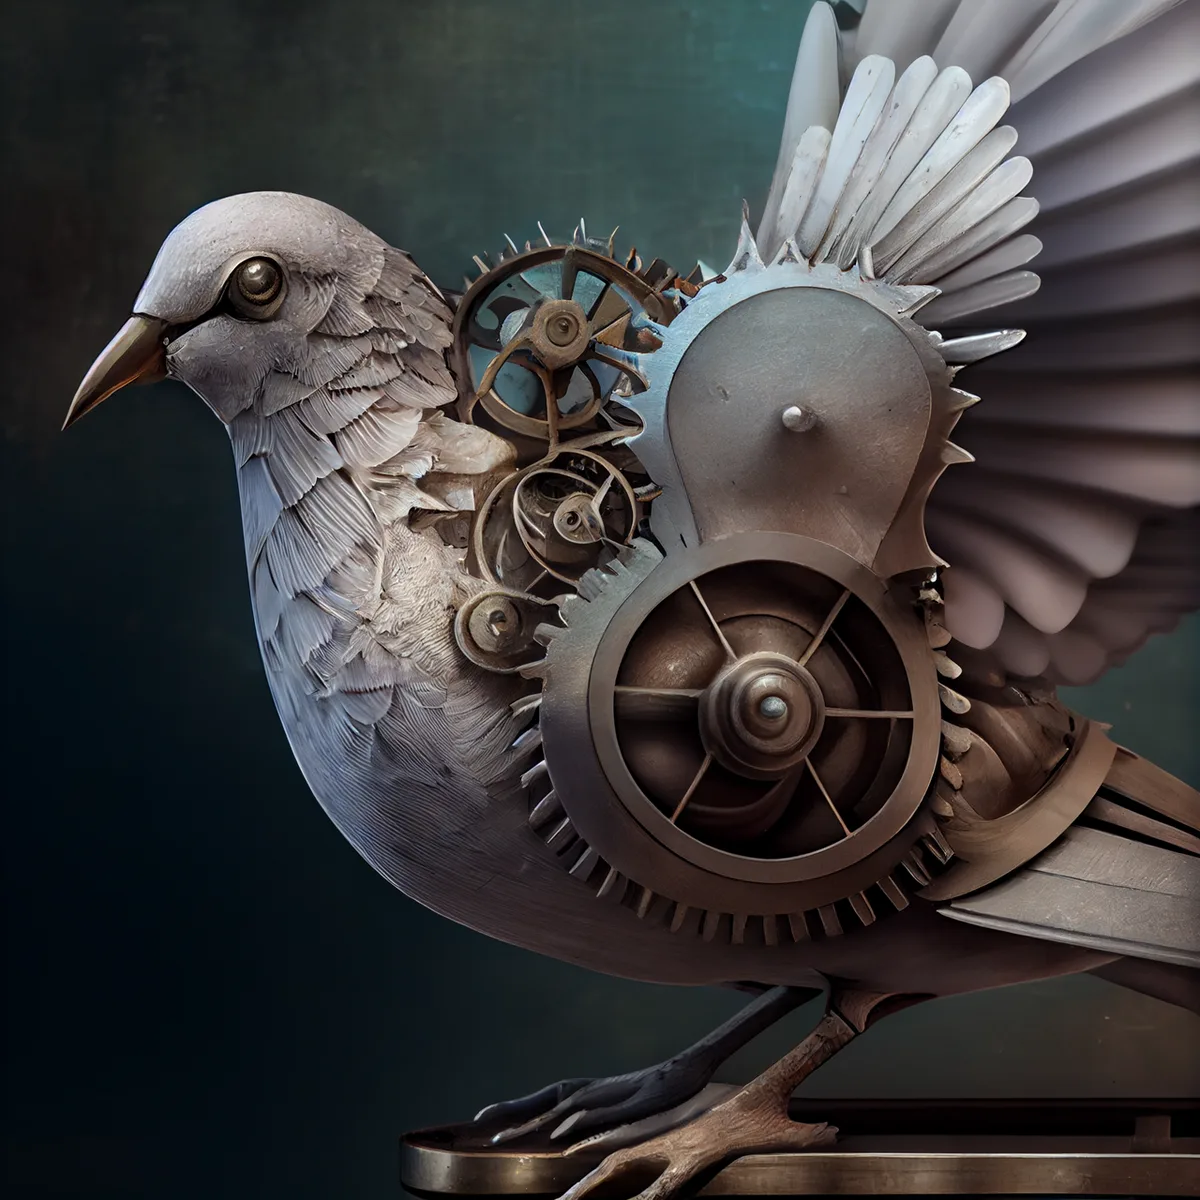
2023-2024 : le réalisme et le texte
Mars 2023 : Adobe lance la bêta de Firefly, son générateur d'images, intégré ensuite à Photoshop.
Octobre 2023 : DALL·E 3 arrive dans ChatGPT. On demande désormais une image au fil de la conversation.
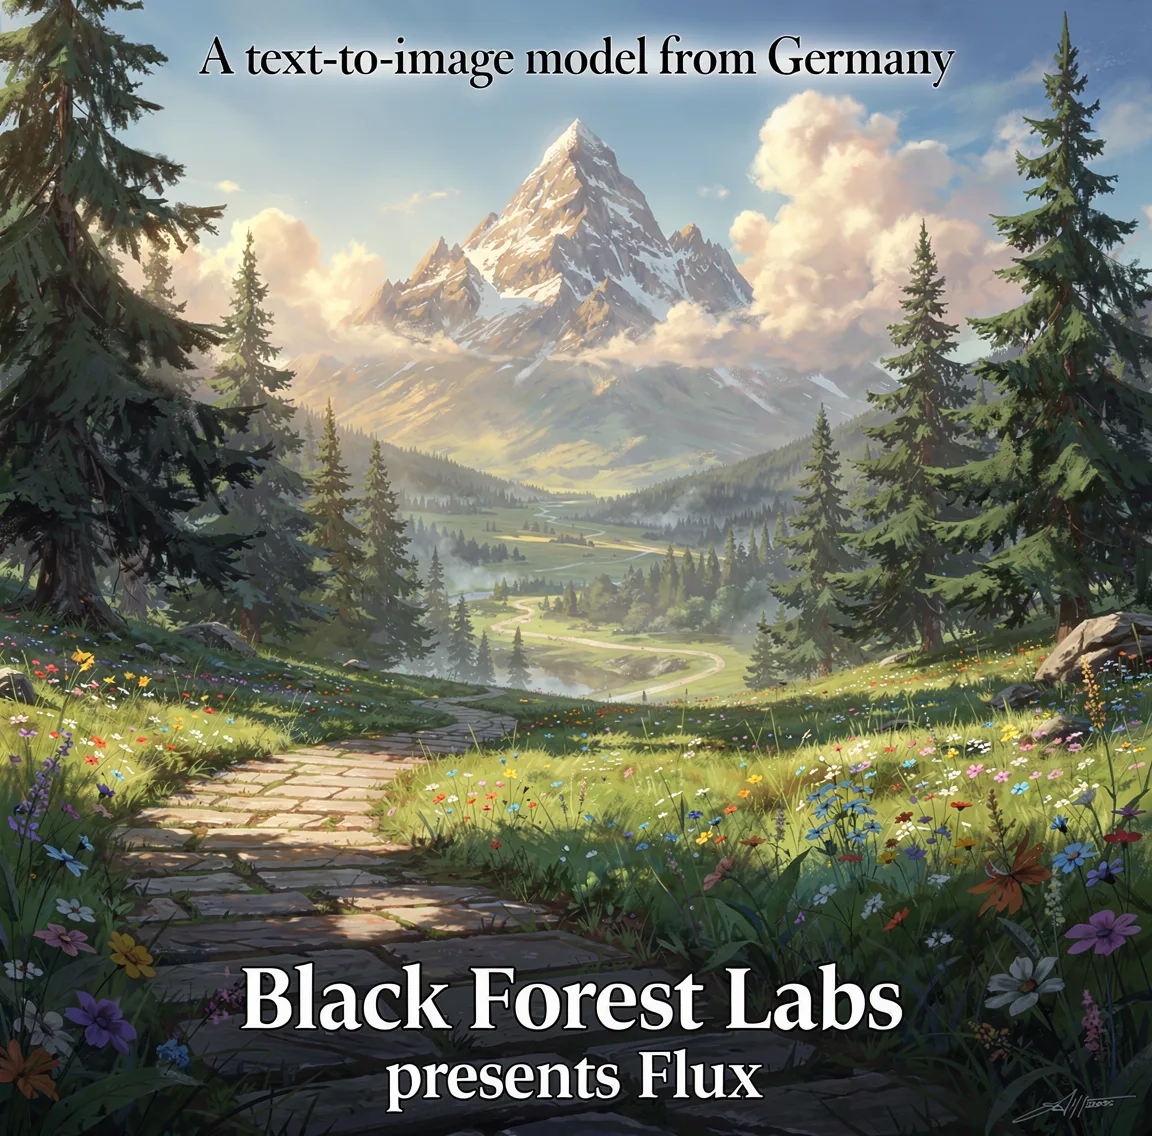
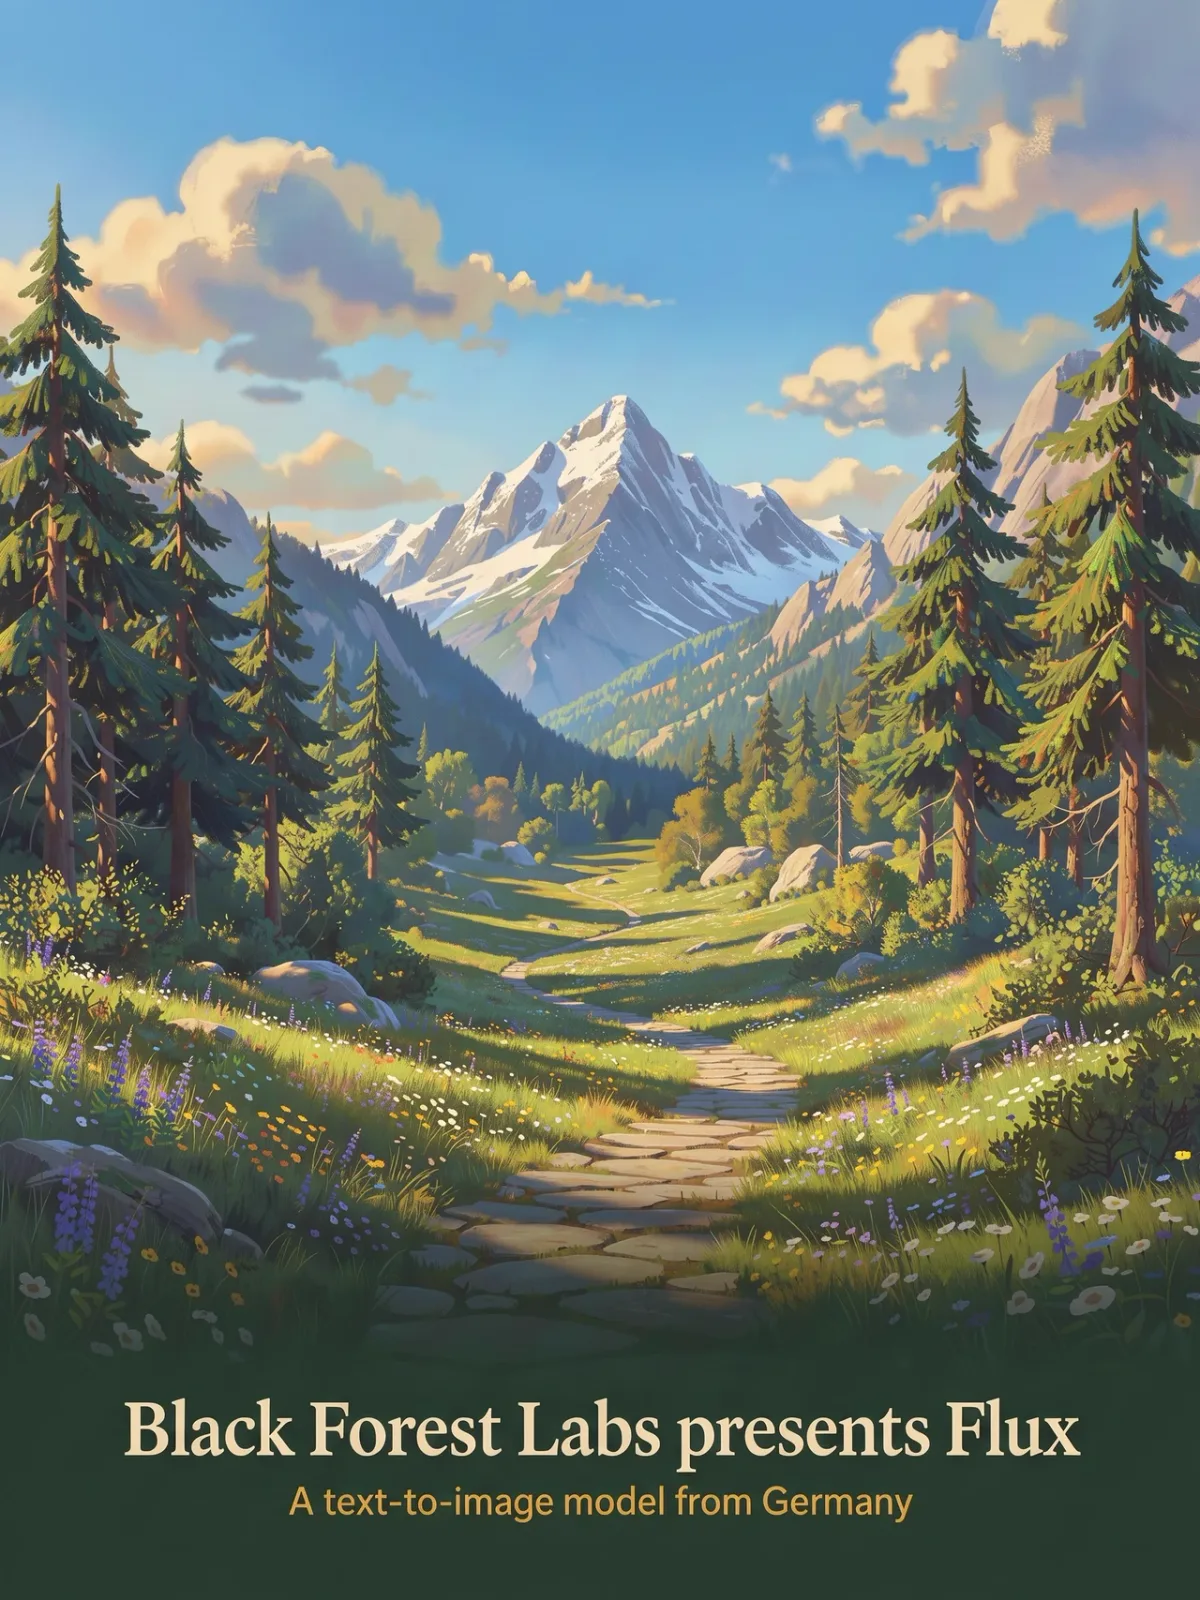
1er août 2024 : Black Forest Labs, fondée par des créateurs de Stable Diffusion, dévoile FLUX.1.
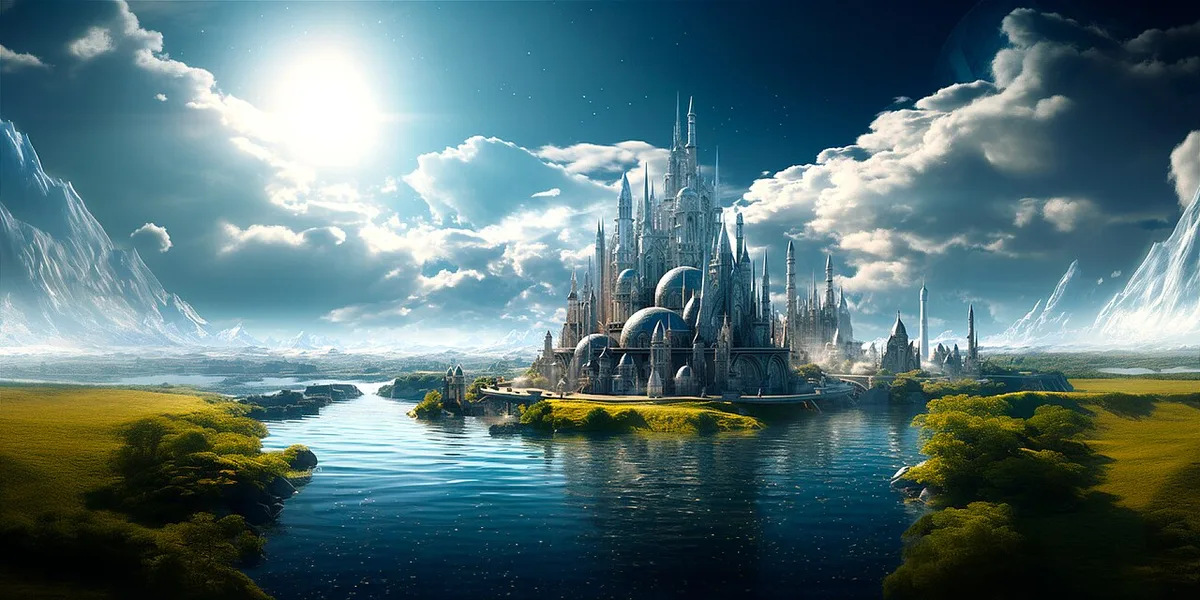
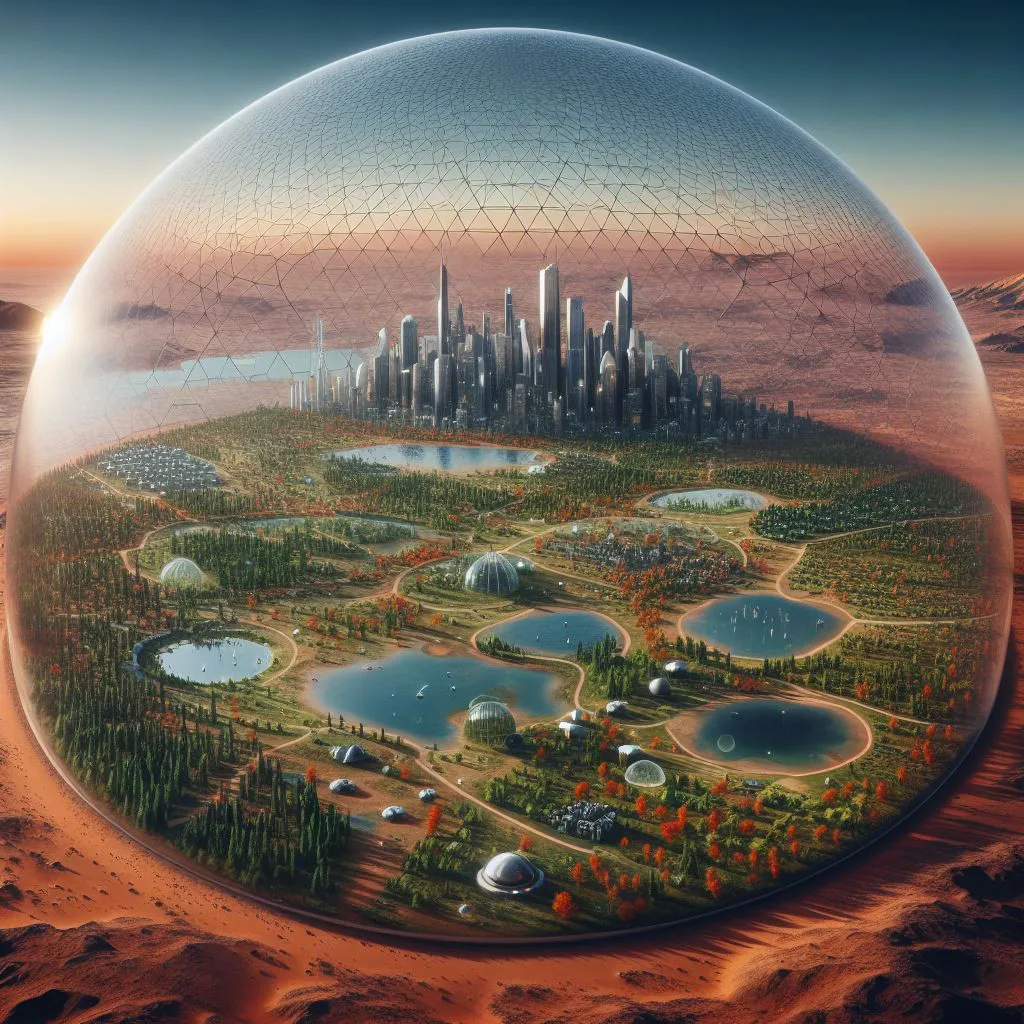
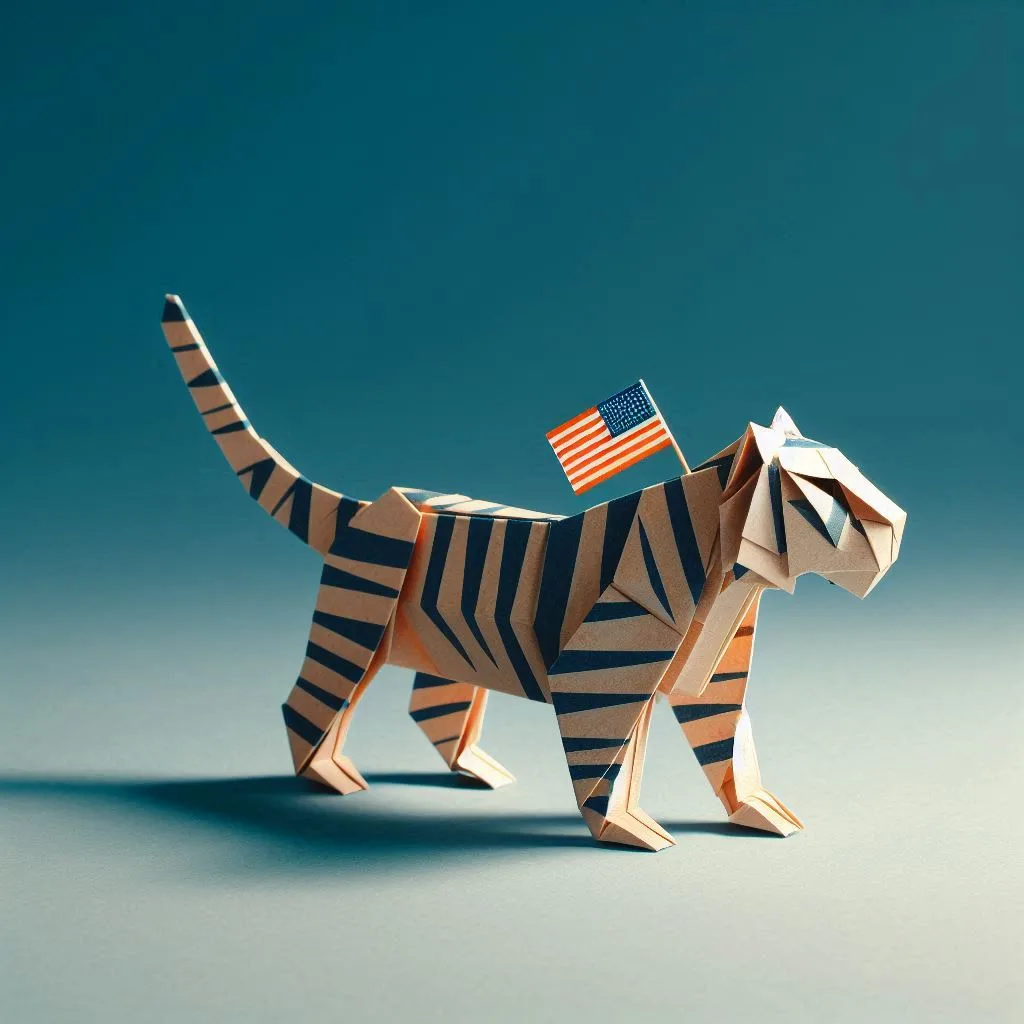
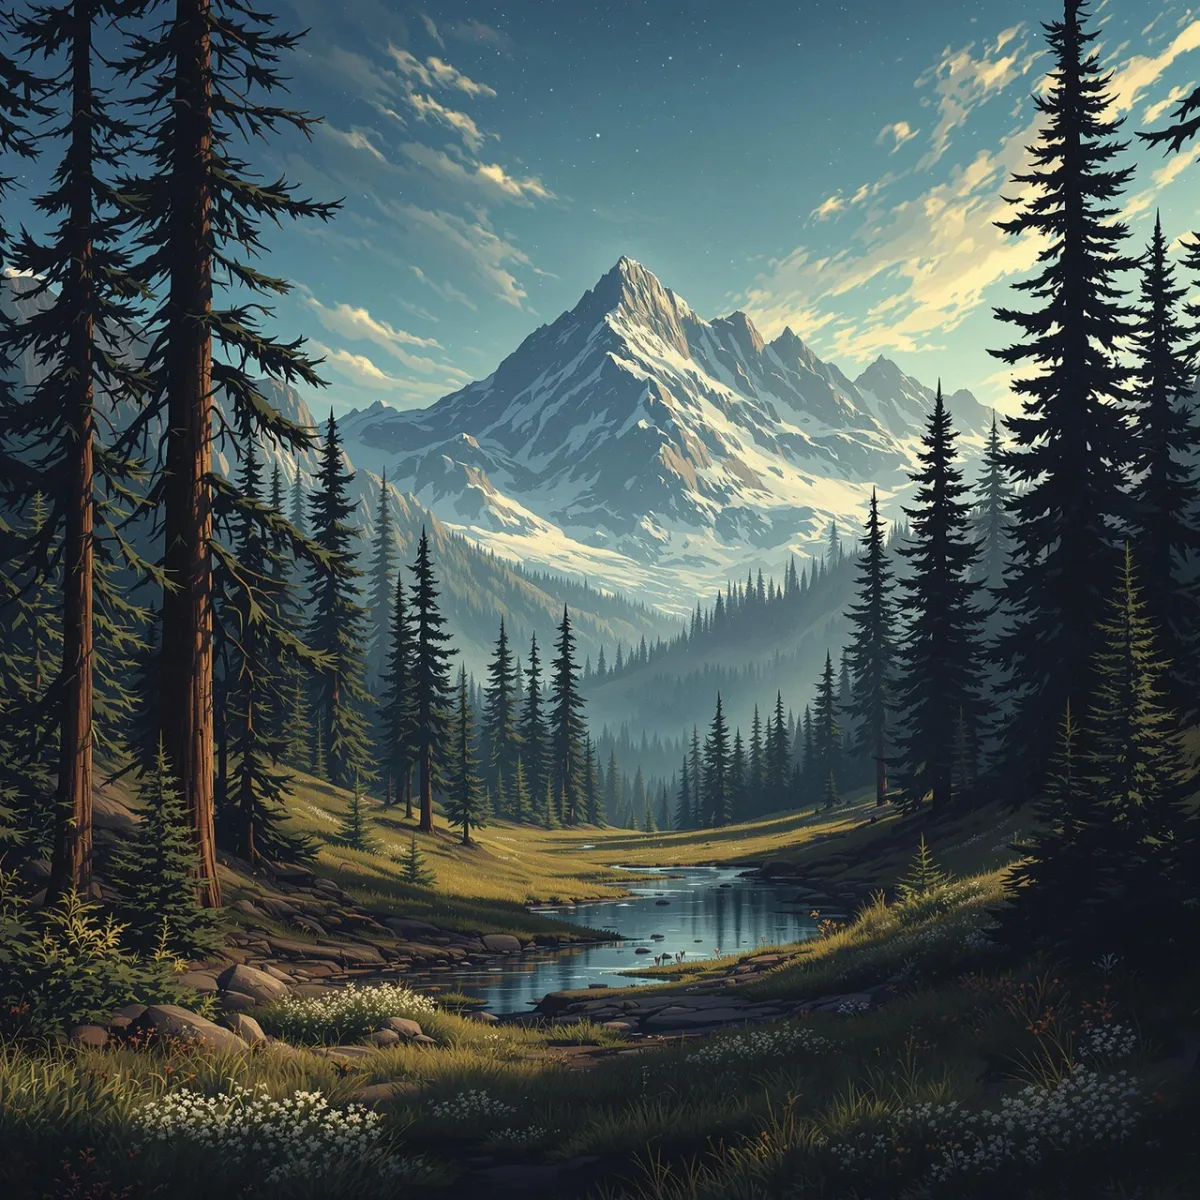
2025-2026 : les assistants dessinent et retouchent
25 mars 2025 : ChatGPT crée désormais les images avec ses propres modèles, y compris dans la version gratuite.
26 août 2025 : Google lance Nano Banana (Gemini 2.5 Flash Image), un modèle de création et de retouche d'images.
20 novembre 2025 : Nano Banana Pro ajoute les images en 2K et 4K et des infographies lisibles.
25 novembre 2025 : Black Forest Labs publie FLUX.2.
16 décembre 2025 : OpenAI publie GPT Image 1.5, jusqu'à 4 fois plus rapide, avec des retouches qui préservent mieux les visages et l'éclairage.
21 avril 2026 : ChatGPT Images 2.0, le premier modèle d'images d'OpenAI qui « réfléchit » avant de dessiner.
2 août 2026 : l'AI Act s'applique dans sa plus grande partie, avec l'obligation de signaler les hypertrucages.
Pour aller plus loin : les pages ChatGPT, Midjourney et Upscale une image.
Crédits des images : Wikimedia Commons, domaine public ou CC0 sauf mention contraire. Pages des fichiers : alignDRAW, DALL·E 2 (Yug, CC BY-SA 4.0), DALL·E 3 (Yug, CC BY-SA 4.0), GPT Image 1, GPT Image 1.5, Edmond de Belamy, StyleGAN2, DALL·E mini, DALL·E 2, Midjourney 2022, Stable Diffusion, Théâtre D'opéra Spatial, Midjourney V4, Midjourney 2023, DALL·E 3, Mars, DALL·E 3, tigre, Ideogram, Firefly, Imagen 3, Stable Diffusion 3.5, FLUX 1.1, Nano Banana, billet, Nano Banana, patchwork, GPT Image 1.5, Wikipédia, GPT Image 2, FLUX.2, FLUX.3.
Commentaires
Pas encore de commentaire. Soyez le premier !